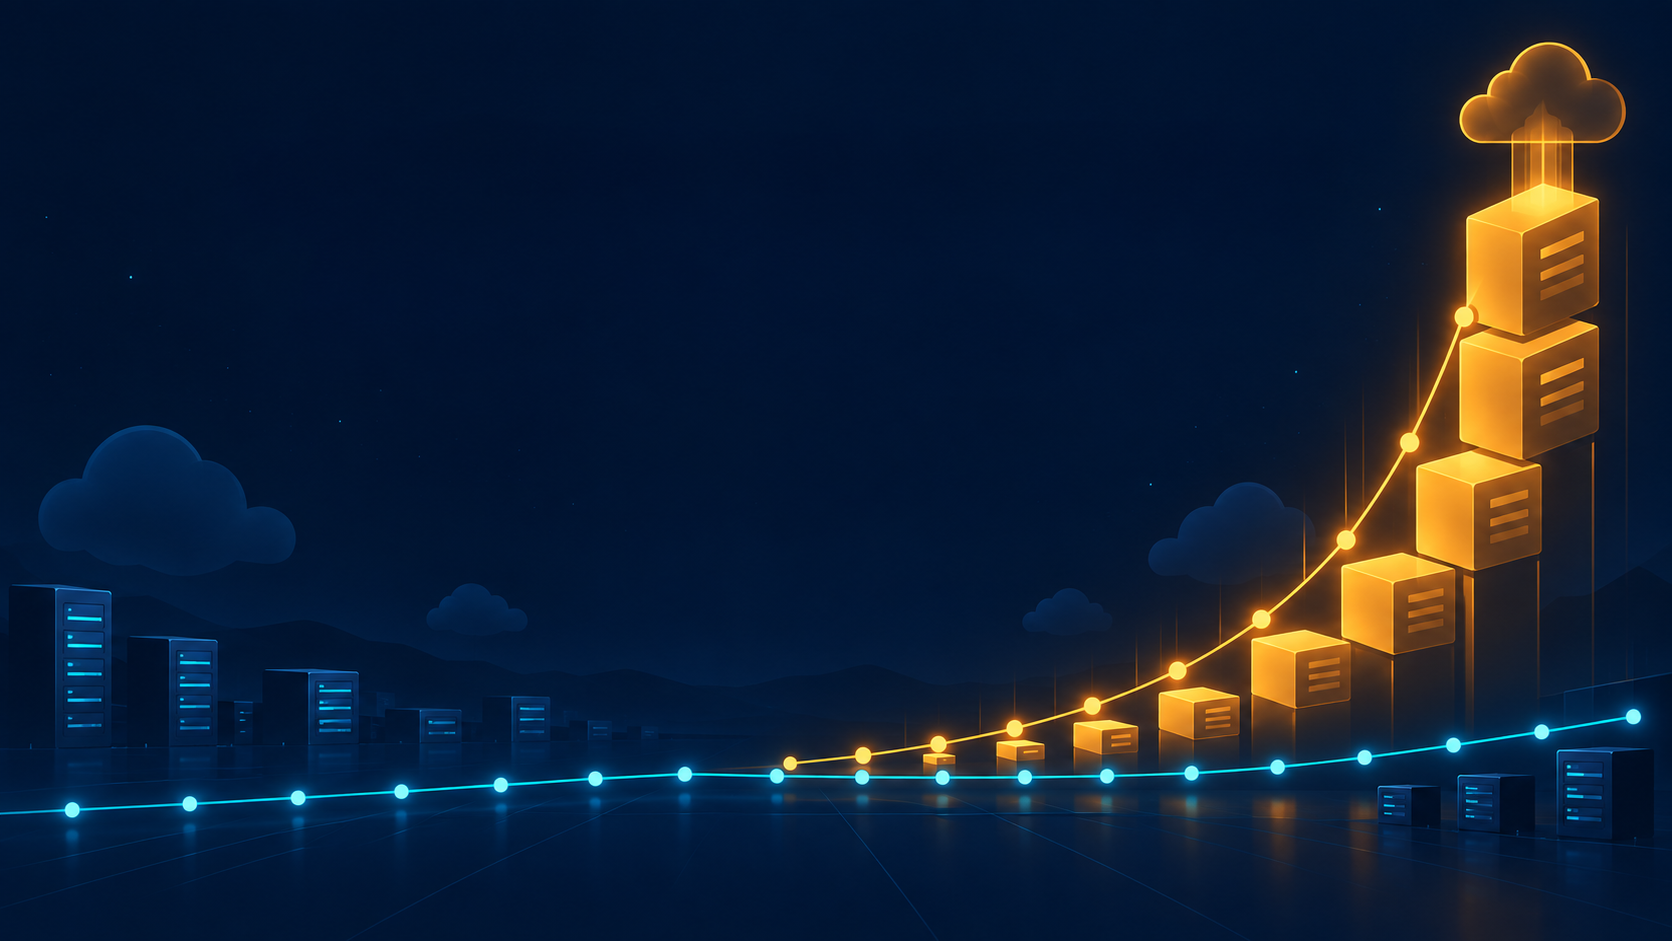
Una curva di costo va letta come una traccia del lavoro svolto, non come la prova automatica di un errore di acquisto.
La curva dei costi dietro l’alert
Il pager segnala saturazione mentre il traffico utile sembra quasi invariato; il giorno dopo, la curva della spesa continua a salire. Non è ancora un problema di procurement: è spesso il primo segnale che il sistema sta facendo più lavoro per ogni richiesta di quanto il prodotto stia restituendo in valore. La tariffa può essere corretta, lo sconto può essere reale, eppure il totale cresce perché cresce il lavoro sottostante.
Per un CTO il danno arriva prima come previsione di spesa che perde affidabilità; per chi mantiene il sistema arriva come capacità consumata senza una causa unica evidente. La stessa curva può contenere retry, fan-out, letture ripetute, trasferimenti di dati e compute trattenuto inattivo. Trattarla come una singola inefficienza porta facilmente a comprare capacità prima di aver capito cosa la sta chiedendo.
Il sintomo nella curva di spesa
Una spesa che cresce più del carico non dimostra che il cloud sia costoso né che il team abbia scelto il contratto sbagliato. Dimostra soltanto una sproporzione da seguire: il costo per unità di lavoro utile sta cambiando, oppure la definizione di lavoro utile è troppo larga per essere diagnostica. Una richiesta ricevuta non equivale necessariamente a una richiesta completata, né un job avviato equivale a un risultato usato da qualcuno.
Anche una riduzione del prezzo unitario può nascondere il problema. Se un accordo, una prenotazione o uno sconto riducono il prezzo di una risorsa, riducono il prezzo, non il numero di operazioni, i byte trasferiti o i tentativi eseguiti. Lo sconto può appiattire la bolletta per un periodo senza cambiare il lavoro che la genera. Quando quel lavoro continua a espandersi, il sistema resta più caro da gestire e più difficile da prevedere.
La lettura utile parte quindi dalla forma della curva, non dalla ricerca immediata di un colpevole. Si osserva quando il rapporto cambia, quali percorsi crescono insieme alla spesa e quali unità tecniche fanno da ponte tra domanda e consumo: tentativi per richiesta, chiamate per flusso, byte per operazione, tempo di compute allocato ma non produttivo. La curva è un indizio, non una sentenza.
Il lavoro aggiuntivo per richiesta
La spesa segue il carico solo quando il lavoro necessario per servire quel carico resta stabile. Nella pratica, ogni richiesta può attivare moltiplicatori che non compaiono nel conteggio degli utenti o delle chiamate in ingresso. Un timeout apre la strada a un retry; una risposta costruita da più dipendenze trasforma una chiamata in fan-out; una lettura già disponibile viene ricostruita attraversando di nuovo la rete.
flowchart LR
    A[Carico: richieste utili] --> B{Moltiplicatori di lavoro}
    B --> C[Retry e timeout]
    B --> D[Fan-out tra servizi]
    B --> E[Movimento e serializzazione dei dati]
    B --> F[Capacità inattiva con domanda diseguale]
    C --> G[Operazioni, byte e tempo di compute]
    D --> G
    E --> G
    F --> G
    G --> H[Spesa cloud]
    H -. osservazione: rapporto lavoro utile / consumo .-> I[Traccia per richiesta e per percorso]
    I -. individua il moltiplicatore .-> B
Il diagramma non assegna una causa prioritaria: mostra perché la stessa quantità di traffico può produrre quantità diverse di lavoro. Un retry non è solo una seconda chiamata; può ripetere serializzazione, trasferimento, accesso a storage, fan-out e attese che inducono altri timeout. Analogamente, un percorso che legge e scrive lo stesso dato più volte può alzare il consumo pur restando invisibile in una metrica aggregata di richieste.
La capacità inattiva segue un meccanismo diverso ma porta allo stesso risultato. Se la domanda è irregolare, mantenere compute pronto per il picco può lasciare risorse allocate durante i periodi meno intensi. Questo non è automaticamente uno spreco: può essere il prezzo di una latenza iniziale accettabile o di un margine operativo necessario. Il punto è distinguere la riserva intenzionale dalla capacità trattenuta perché l’autoscaling reagisce a un segnale che non rappresenta il lavoro utile.
I punti di rottura del percorso
I retry diventano costosi quando la politica non distingue tra un errore transitorio e un’operazione che non dovrebbe essere ripetuta. Senza idempotenza, il sistema può non solo ripetere lavoro, ma produrre effetti duplicati; con idempotenza, il costo del controllo passa spesso a chi gestisce chiavi, stato e scadenze. L’affidabilità paga in complessità di stato, e ignorare quel costo rende il retry una scelta apparentemente gratuita.
Il fan-out si rompe quando una richiesta di prodotto richiede molte dipendenze per completarsi e una di esse rallenta. Il chiamante aspetta, alcune chiamate restano aperte, altre vengono ritentate e la pressione si propaga. Mettere una cache davanti a un percorso può ridurre il lavoro, ma sposta il prezzo: la cache introduce regole di invalidazione, dati meno freschi o una semantica diversa durante un guasto. Non è un argomento contro la cache; è un motivo per definire quale freschezza il prodotto può davvero pagare.
Il movimento dei dati ha la stessa dinamica. Un payload troppo ricco, una serializzazione ripetuta o un passaggio non necessario tra componenti possono far crescere byte e tempo senza aggiungere valore per l’utente. Ridurre quel lavoro con batching può migliorare l’efficienza, ma chi riceve il costo è il percorso che deve aspettare una finestra di accumulo; la latenza percepita e il comportamento in caso di errore cambiano. Ridurre lavoro non significa conservare tutte le proprietà del percorso precedente.
Anche l’autoscaling può amplificare un errore di lettura. Se scala su richieste in ingresso mentre il problema è una dipendenza lenta, aggiungere istanze può aumentare le chiamate concorrenti verso quella dipendenza e accrescere timeout e retry. Se scala su CPU mentre il collo di bottiglia è l’attesa di rete, può vedere un sistema apparentemente calmo fino a quando le code non sono già cresciute. Il segnale di scala deve rappresentare il vincolo, non soltanto essere disponibile.
strumentazione:
  richiesta:
    chiave_traccia: richiesta_id
    misure:
      - tentativi_per_operazione
      - chiamate_per_richiesta
      - byte_letti_e_scritti
      - tempo_allocato_e_tempo_produttivo
  autoscaling:
    anti_pattern: richieste_in_ingresso_senza_latenza_della_dipendenza
Questo blocco non prova che il problema esista in un ambiente specifico; indica soltanto una forma di strumentazione che rende confrontabili domanda, lavoro e consumo. La chiave è conservare il legame tra una richiesta utile e le operazioni che genera, invece di confrontare soltanto dashboard aggregate.
La diagnosi lungo una richiesta utile
La diagnosi comincia scegliendo un percorso che il prodotto considera riuscito: un’operazione completata, un contenuto consegnato, un job con output usato. Si segue poi una richiesta utile dall’ingresso all’ultimo effetto, annotando tentativi, chiamate a valle, letture, scritture, byte trasferiti e tempo in attesa. Non serve assumere che tutte le richieste siano identiche; serve vedere quali differenze spiegano il lavoro aggiuntivo.
Il confronto più utile non è tra due fatture, ma tra richieste che producono lo stesso esito con costi operativi diversi. Una richiesta lenta può aver effettuato più tentativi; una risposta più cara può avere attraversato un fan-out più ampio; un periodo di spesa costante può contenere capacità pronta per una domanda che non è arrivata. Si cerca il rapporto che si è mosso, non una metrica isolata che sembri anomala.
| Intervento | Lavoro che può ridurre | Costo o comportamento che sposta |
|---|---|---|
| Cache | letture e calcoli ripetuti | freschezza, invalidazione, diagnosi degli errori |
| Batching | chiamate e trasferimenti frammentati | latenza di attesa, gestione dei fallimenti parziali |
| Backpressure | lavoro in eccesso durante la saturazione | rifiuto, attesa o degradazione visibile al prodotto |
| Idempotenza | effetti e tentativi duplicati | stato, chiavi di deduplicazione, regole di scadenza |
| Vincoli di prodotto | percorsi costosi richiesti troppo spesso | funzionalità, tempi di risposta o aspettative dell’utente |
La tabella serve a evitare una falsa alternativa tra riduzione dei costi e qualità del servizio. Ogni scelta cambia chi assorbe la conseguenza. Il caching la porta verso chi accetta dati meno freschi; il batching verso chi accetta attesa; la backpressure verso il prodotto e gli utenti nei momenti di pressione; l’idempotenza verso chi deve operare e mantenere uno stato più esplicito. Il trade-off va deciso nel percorso, non rimosso dal racconto della spesa.
Un’azione reversibile sulla curva
Prima di cambiare un contratto o riscrivere un componente, conviene scegliere un solo percorso costoso e dichiarare quale rapporto si vuole osservare: tentativi per esito riuscito, chiamate a valle per richiesta utile, byte per risultato, oppure tempo allocato rispetto al tempo che produce lavoro. La scelta di un percorso limita il raggio dell’indagine e rende più chiaro se una modifica ha ridotto davvero lavoro anziché spostarlo altrove.
Una prima correzione dovrebbe essere reversibile. Si può limitare il fan-out non necessario su un percorso, aggiungere backpressure a una coda che accumula lavoro inutile, o rendere visibili i retry prima di decidere di cambiarne la politica. Per i casi in cui la domanda segue ritmi prevedibili, la pianificazione della capacità sul calendario offre un confronto utile con la capacità regolata soltanto dagli allarmi. Una modifica piccola produce un segnale più leggibile di una riorganizzazione generale.
Se il problema confermato riguarda il lavoro per richiesta, la discussione non è più una negoziazione sul prezzo di una risorsa. Diventa una decisione di progettazione su dove ridurre, accumulare, rimandare o rifiutare lavoro. È il tipo di analisi che appartiene alla pratica di scaling: collegare la capacità al comportamento reale del sistema, senza scambiare un sintomo finanziario per una causa tecnica.
Domande frequenti
Uno sconto o una prenotazione possono risolvere la crescita della spesa?
Possono cambiare il prezzo pagato per capacità, e quindi avere senso come decisione economica. Non riducono però retry, fan-out, trasferimenti o capacità inattiva; se il lavoro continua a crescere, il segnale progettuale resta presente anche con una fattura temporaneamente più bassa.
Quando una cache peggiora il problema invece di risolverlo?
Peggiora il sistema quando nasconde un percorso che continua a fare lavoro inutile nelle cache miss, oppure quando la sua invalidazione introduce comportamenti che il prodotto non sa gestire. Una cache è una scelta di freschezza e operatività, non una scorciatoia automatica per ridurre il costo.
L’autoscaling non dovrebbe eliminare la capacità inattiva?
L’autoscaling riduce capacità non necessaria soltanto se il segnale scelto rappresenta la pressione che conta e se il sistema può reagire in tempo. Con domanda irregolare o dipendenze lente, scalare sul segnale sbagliato può mantenere risorse inattive oppure aumentare la concorrenza verso il collo di bottiglia.
Da quale metrica conviene iniziare se non esiste una traccia completa?
Si parte da una metrica che colleghi un esito utile a un moltiplicatore osservabile, come tentativi per operazione riuscita o chiamate per richiesta completata. La prima metrica non deve spiegare tutto: deve indicare quale percorso tracciare per primo.
Scegli oggi un percorso che pesa sulla spesa, aggiungi la misura del suo lavoro per esito utile e lascia invariato il resto finché quel rapporto non indica dove intervenire.