Tempi di scrittura, attese e correzioni raccontano cose diverse: una misura del flusso completo aiuta a capire dove l’AI fa risparmiare lavoro e dove lo sposta.
La PR pronta e la consegna ferma
La PR generata con l’AI passa i controlli, chi l’ha aperta dice di aver fatto prima, ma durante la review non riesce a spiegarti perché quella modifica sia corretta. Intanto le PR pronte aumentano, mentre i deploy e il lavoro da rifare non migliorano. Per capire se l’AI abbia accelerato la consegna, devi seguire l’intero percorso della modifica, non fermarti al momento in cui il codice sembra finito.
Il tempo risparmiato dall’autore può essere reale senza diventare un vantaggio per il team. Se la spiegazione manca, qualcuno dovrà ricostruire le assunzioni, verificare i casi limite o chiedere una riscrittura; se invece il codice è corretto ma attende una finestra di rilascio, l’accelerazione resta prima di quella coda. Sono problemi diversi, che richiedono decisioni diverse.
La domanda utile non è quindi quanto codice produca un assistente, né se l’AI renda universalmente più produttivi. È se, per una classe di attività comparabili nella stessa applicazione, il workflow assistito porti modifiche in produzione prima, senza trasferire un costo inaccettabile alla review o alla manutenzione. Il deploy segna un passaggio osservabile della consegna: non dimostra ancora che una funzionalità sia disponibile agli utenti, utilizzata o utile.
Il percorso oltre la generazione
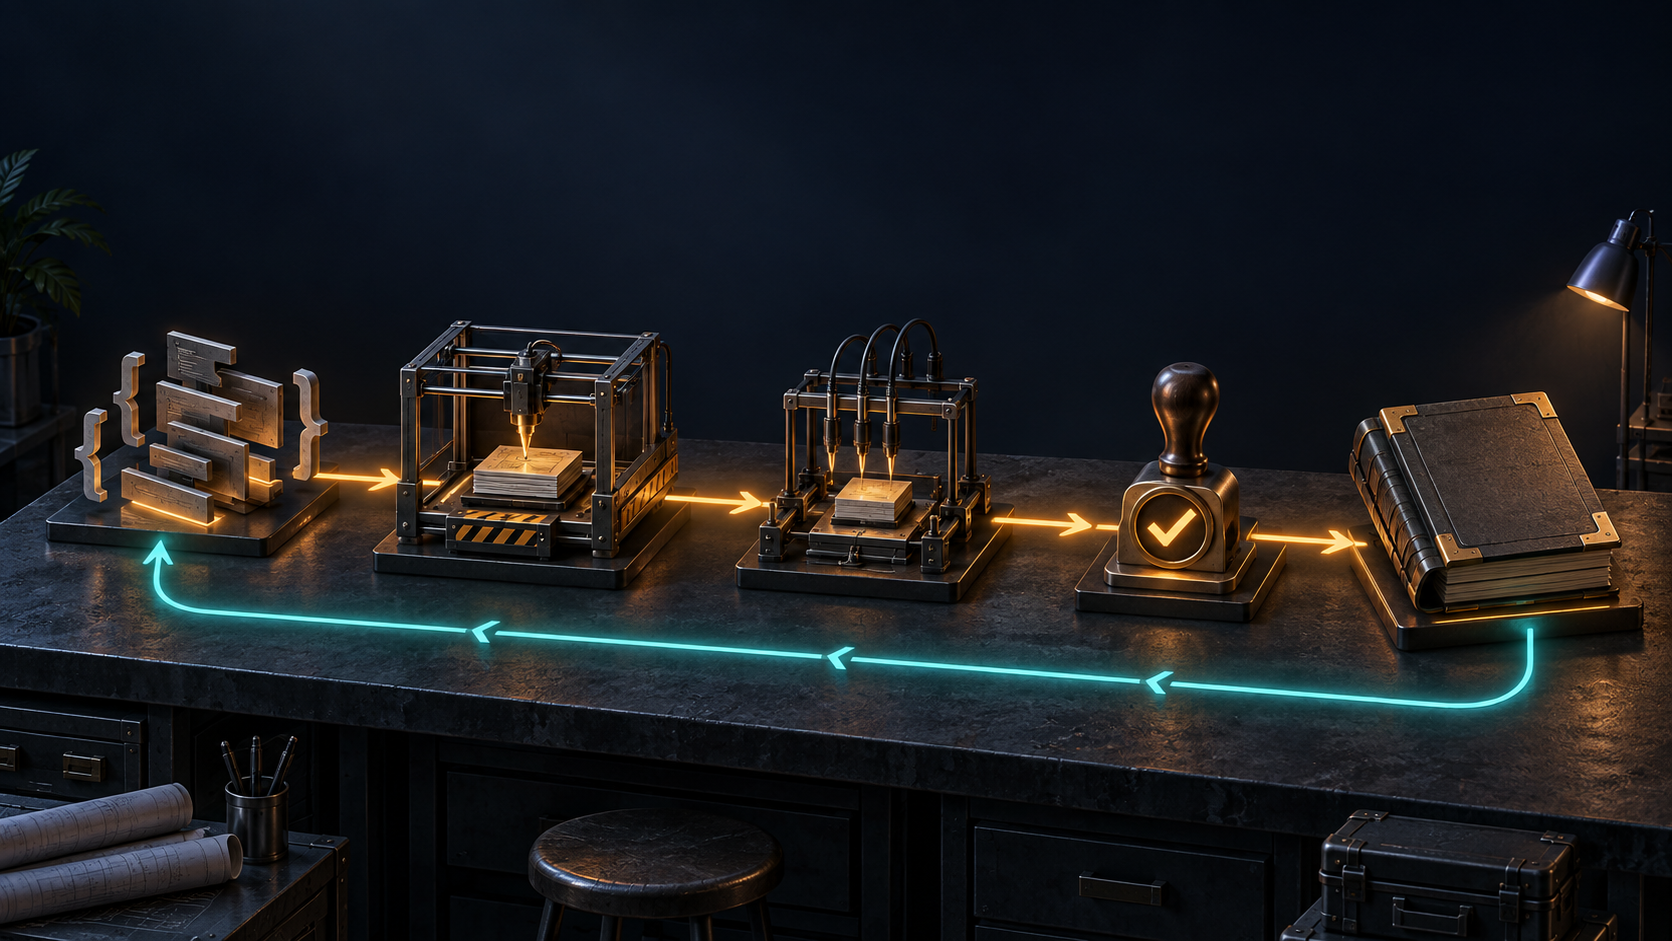
La generazione può ridurre il tempo locale di lavorazione, cioè quanto impieghi a preparare una modifica. Il tempo trascorso dall’avvio dell’attività al deploy comprende però anche attese, passaggi di responsabilità e ritorni su lavoro già considerato pronto. Migliorare un tratto non implica che si accorci tutto il percorso.
Il diagramma distingue la preparazione dalle code e mostra due ritorni che una semplice sequenza di stati tende a nascondere. La review può riportare la modifica in preparazione; dopo il deploy, un problema osservato può aprire altro lavoro. Le correzioni appartengono al percorso, anche quando finiscono in una PR diversa.
flowchart TD
    A["Avvio dell’attività"] --> B["Preparazione e generazione"]
    B --> C["Pronta per la review"]
    C --> D["Attesa e svolgimento della review"]
    D --> E{"Correzioni richieste?"}
    E -->|"Sì"| B
    E -->|"No"| F["Merge"]
    F --> G["Attesa del rilascio"]
    G --> H["Deploy in produzione"]
    H --> I{"Problema osservato?"}
    I -->|"Sì"| J["Correzione o rifacimento"]
    J --> B
    I -->|"No"| K["Osservazione degli esiti"]
Il tratto fra disponibilità per la review e merge contiene sia attese sia interventi: può includere una prima lettura, domande, nuove versioni e una seconda verifica. I soli timestamp non separano queste componenti. Se quel tratto si allunga, hai individuato dove indagare, non dimostrato che il reviewer sia lento o che il codice generato sia peggiore.
Lo stesso vale per l’attesa del rilascio. Quando molte modifiche convergono su pochi momenti di deploy, anticipare la preparazione potrebbe non cambiare la data di arrivo in produzione. È il motivo per cui i problemi di consegna possono dipendere dalla struttura del lavoro: velocità di una fase e capacità del sistema non sono la stessa cosa.
Gli indicatori fuori bersaglio
Il primo errore è usare una misura disponibile come se rispondesse alla domanda che interessa. Token, suggerimenti accettati e righe prodotte sono facili da contare, ma non dicono se la modifica fosse necessaria, comprensibile o pronta per essere mantenuta. Anche il numero di PR cambia se cambia il modo di suddividere il lavoro: più unità registrate non equivalgono a più valore consegnato.
Una lettura utile mette insieme segnali con funzioni differenti, senza comprimerli in un punteggio di produttività individuale.
| Segnale | Cosa permette di osservare | Limite da rispettare | Decisione che può informare |
|---|---|---|---|
| Token, righe, suggerimenti accettati, numero di PR | Attività e uso dello strumento | Non misurano valore consegnato o qualità | Capire dove viene usato l’assistente |
| Tempo locale dichiarato dall’autore | Difficoltà e possibile risparmio nella preparazione | Non include necessariamente review, attese e correzioni | Esaminare una specifica fase del workflow |
| Tempo trascorso lungo la catena e nei suoi tratti | Dove la modifica avanza o rimane ferma | Localizza il ritardo, non ne identifica la causa | Scegliere quale passaggio approfondire |
| Difetti sfuggiti e lavoro da rifare | Qualità dopo la prima accettazione | Non sono automaticamente attribuibili all’AI | Limitare o rivedere un uso rischioso |
| Riscontri di autore e reviewer | Assunzioni mancanti, incomprensioni, contesto | Non sostituiscono una misura del tempo | Correggere istruzioni e modalità di review |
Il secondo errore è osservare soltanto ciò che arriva al deploy. Se escludi attività abbandonate, bloccate o ancora aperte, ottieni una vista dei soli casi completati che può nascondere proprio le difficoltà del workflow. I casi incompleti vanno riportati separatamente, con il loro stato: non sono durate nulle e non devono sparire dal confronto.
Anche il lavoro correttivo richiede attenzione. Se una PR di correzione nasce da una modifica precedente, mantieni il collegamento; se autore e reviewer lavorano contemporaneamente, non sommare le loro ore al tempo trascorso come se fossero grandezze equivalenti. Tempo di calendario e impegno delle persone rispondono a domande diverse.
Le tracce per la diagnosi
Parti da eventi che il team sappia riconoscere senza interpretazioni retroattive. Definisci cosa significa avvio dell’attività: presa in carico, inizio dell’analisi o primo intervento sul codice non sono intercambiabili. Scegli una definizione e mantienila. Per ogni modifica registra avvio, disponibilità per la review, merge e deploy in produzione, usando date e orari con offset del fuso orario.
L’intervallo dall’avvio al deploy è una misura interna del percorso scelto, non il change lead time DORA. La definizione DORA del change lead time parte dal commit e arriva alla produzione; la stessa guida invita a leggere le metriche nel contesto dell’applicazione o del servizio, evitando confronti impropri e obiettivi costruiti su un solo indicatore. Conserva il nome e il confine della misura che stai effettivamente raccogliendo.
Questo helper calcola tre intervalli consecutivi a partire dai quattro eventi. Gli identificatori rimangono quelli del codice: started, review_ready, merged e deployed sono le chiavi che il chiamante deve fornire.
from datetime import datetime


def elapsed_stages(events):
    names = ("started", "review_ready", "merged", "deployed")
    times = [datetime.fromisoformat(events[name]) for name in names]
    if any(t.tzinfo is None for t in times):
        raise ValueError("Timezone required")
    if any(right < left for left, right in zip(times, times[1:])):
        raise ValueError("Events out of order")
    return {
        f"{left}_to_{right}": (end - start).total_seconds()
        for left, right, start, end in zip(names, names[1:], times, times[1:])
    }
I valori restituiti sono secondi trascorsi, non ore lavorate. Il codice è stato verificato con dati sintetici per controllare gli intervalli corretti, gli eventi fuori ordine, un campo mancante e l’assenza del fuso orario; queste verifiche riguardano il comportamento dell’helper, non producono osservazioni sulla produttività di un team.
Il chiamante deve passare eventi completi, ordinati e dotati di fuso orario. Una chiave assente genera un errore invece di far scartare silenziosamente l’attività; un timestamp senza fuso o una sequenza invertita viene rifiutato. Non inserire valori sostitutivi per far passare i casi incompleti: gestiscili nel resoconto delle evidenze mancanti.
Quattro timestamp restano una sintesi. Quando una modifica torna più volte in preparazione, viene riaperta o richiede un nuovo deploy, serve la cronologia degli eventi per ricostruirne i passaggi. Il primo review_ready non racconta da solo quanto lavoro sia stato necessario prima del merge, né la prima consegna esaurisce il costo delle correzioni successive.
Una prova circoscritta del workflow AI
Prima di confrontare periodi o workflow, stabilisci il perimetro: stessa classe di attività, repository, rischio, regole di review e cadenza di rilascio. Registra anche variazioni di organico, festività, interruzioni, cambi di processo e dimensione delle modifiche. La comparabilità va costruita, non dedotta dal fatto che tutte le righe provengano dallo stesso sistema di ticketing.
Per il riferimento iniziale usa artefatti precedenti realmente confrontabili, se esistono. Se mancano eventi affidabili, avvia una raccolta prospettica invece di ricostruire tempi di comodo. Un confronto prima-dopo, soprattutto quando ciascuno sceglie autonomamente se usare l’AI, può mostrare un’associazione: non isola l’effetto causale dello strumento da esperienza, selezione delle attività o cambiamenti nel lavoro.
Concorda prima della prova chi ne risponde, la definizione di lavoro completato, il limite accettabile sul fronte qualità e una data di riesame. Prevedi tre esiti praticabili: continuare, restringere l’uso o interromperlo. In questo modo la scelta dei workflow AI da adottare deliberatamente dipende da una verifica circoscritta, anziché dalla necessità di giustificare un’adozione già decisa.
Se la preparazione si accorcia mentre aumentano le richieste di chiarimento, esamina con autore e reviewer cosa manca nella PR. Potrebbe servire una spiegazione delle assunzioni, una modifica più piccola o una verifica indipendente dei test generati: la code review con AI richiede spiegazioni, non fiducia. La risposta diagnostica segue il punto di attrito, senza trasformare ogni ritardo in un problema di prompting.
Raccogli solo ciò che può cambiare una decisione. Un’etichetta grossolana sull’assistenza ricevuta nel workflow, accompagnata da eventi e note essenziali, può bastare senza conservare prompt o conversazioni sensibili. Se il team deve imparare a delimitare gli usi e discutere le verifiche, la formazione sull’AI applicata al lavoro del team riguarda anche queste competenze. La strumentazione ha un costo, pagato da chi registra e da chi interpreta: rendilo proporzionato alla decisione, non alla quantità di dati tecnicamente accessibili.
Domande frequenti
Cosa possiamo capire con pochi casi in un team piccolo?
Un campione ridotto può orientare una diagnosi, non sostenere percentuali generali di miglioramento. Esamina le singole traiettorie, le attività non completate e le differenze di contesto; dichiara cosa resta incerto e usa il riesame per decidere se proseguire la raccolta o restringere il perimetro.
Cosa misurare se mancano i timestamp di deploy?
Fermati all’ultimo evento verificabile e dichiara quel confine. Se disponi soltanto del merge, puoi studiare il percorso fino all’integrazione, non affermare di aver misurato la consegna in produzione. Collega i deploy alle modifiche prima della prova successiva, senza ricavare date presunte dal merge.
Come misurare senza conservare prompt riservati?
Non serve sorvegliare le conversazioni per osservare il flusso. Concorda una classificazione essenziale dell’assistenza usata, limita accessi e conservazione ed evita contenuti riservati nelle note. Le evidenze devono aiutare il team a cambiare un processo, non costruire classifiche delle persone.
Cosa cambia se sostituiamo strumento o processo durante la prova?
Segna il cambiamento e separa i periodi quando altera il confronto. Un altro modello, una nuova policy di review o una diversa cadenza di rilascio cambiano le condizioni osservate; non attribuire all’AI una variazione che potrebbe dipendere da questi passaggi, né trattare il periodo come un esperimento rimasto invariato.
Scegli una modifica circoscritta e comparabile, ricostruiscila dall’avvio al deploy con autore e reviewer e annota le evidenze mancanti prima di scrivere che l’AI ha accelerato la consegna.