Meça o caminho da tarefa até produção, incluindo revisão, filas e retrabalho, para avaliar o ganho com IA sem confundir mais código com entrega mais rápida.
O PR pronto e a entrega parada
O PR gerado com IA passou nos checks, mas, durante o code review, quem escreveu não consegue explicar por que a mudança está correta. Você pede ajustes, o autor volta ao editor e a entrega segue esperando. A sensação de velocidade existiu; só que o relógio do autor parou antes do relógio de quem precisava da mudança.
Para medir se a IA acelerou a entrega de software, acompanhe o percurso inteiro de mudanças comparáveis, do início da tarefa ao deploy, sem tirar revisão e correção da conta. Depois, confronte esse percurso com a qualidade do que chegou a produção. Isso permite avaliar um workflow no seu contexto, não declarar que IA aumenta ou reduz a produtividade de qualquer time.
É possível terminar a implementação antes e não entregar antes. Se a revisão já era a etapa disputada, colocar mais código na entrada pode apenas aumentar sua fila. E, se a explicação que o autor deixou de construir precisa ser refeita por outra pessoa, houve transferência de esforço, não necessariamente economia.
Esse é um motivo para tratar problemas de entrega como problemas de estrutura, em vez de atribuir todo atraso à habilidade de escrever código. A ferramenta participa do fluxo; ela não substitui as dependências entre quem prepara, revisa, aprova e publica.
O deploy em produção serve aqui como marco de entrega técnica. Uma funcionalidade atrás de uma flag pode continuar indisponível para os usuários, e estar disponível também não prova que trouxe benefício. Se a decisão depende desse benefício, registre a liberação e o resultado esperado à parte, sem trocar silenciosamente o ponto final da medição.
O relógio entre a tarefa e produção
A distinção central é entre tempo de trabalho ativo e tempo decorrido. Uma mudança pode passar por poucas intervenções e, ainda assim, atravessar uma longa espera por aprovação ou pela janela de release. O tempo entre dois eventos inclui tudo isso, inclusive noites, fins de semana e interrupções.
Defina um início que você consiga reconhecer da mesma forma nas tarefas comparadas. Pode ser quando alguém começa a executar uma tarefa com escopo aceito; não pode ser esse momento em um caso e a abertura tardia do PR em outro. A definição de tarefa iniciada precisa vir antes da coleta, não depois de olhar os resultados.
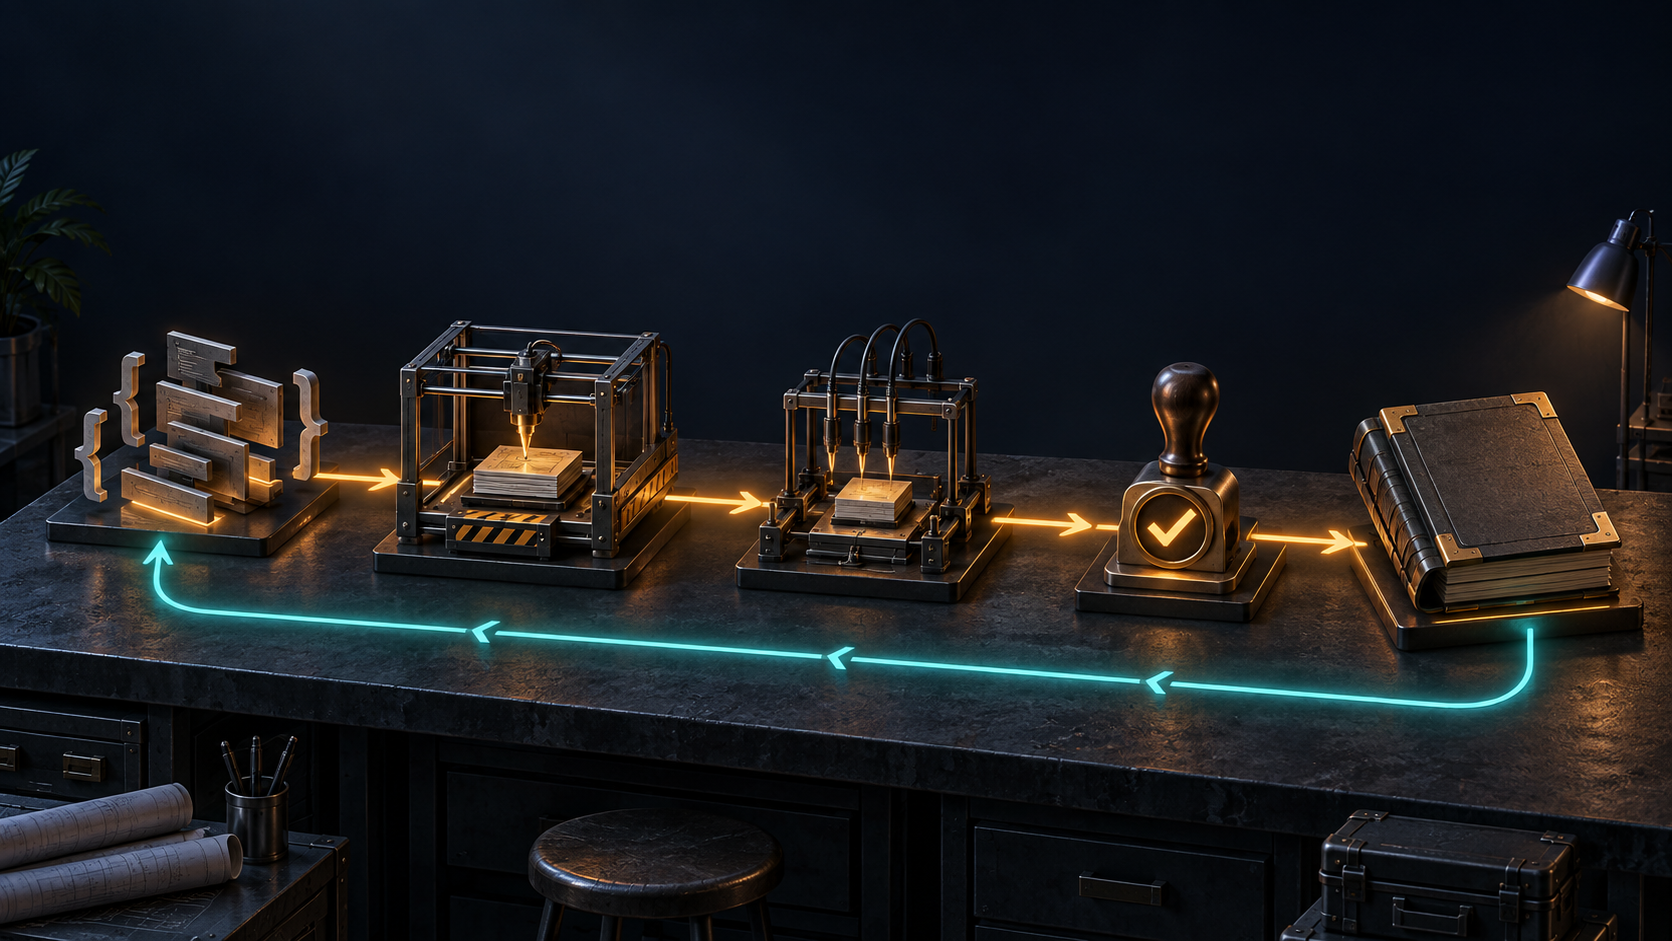
O caminho abaixo separa os marcos e deixa os retornos visíveis. Preparar a mudança inclui geração e trabalho manual; depois de ficar pronta para revisão, ela pode voltar para correção antes do merge. Mesmo após o merge, há espera pela publicação, e uma falha observada em produção pode abrir novo trabalho.
flowchart TD
    A["Início da tarefa"] --> B["Preparação e geração de código"]
    B --> C["Pronta para revisão"]
    C --> D["Revisão da mudança"]
    D -->|"Correção necessária"| B
    D -->|"Aprovada"| E["Merge"]
    E --> F["Espera pela publicação"]
    F --> G["Deploy em produção"]
    G --> H{"Falha ou retrabalho observado?"}
    H -->|"Sim: nova correção"| B
    H -->|"Não"| I["Continuar observando resultados"]
Na prática, a fronteira da medição decide o que desaparece. Se você encerra a conta ao abrir o PR, os retornos da revisão ficam de fora. Se encerra no merge, a espera pelo release some. Se olha apenas as tarefas concluídas, as abandonadas deixam de incomodar o resultado.
Os marcos também precisam ter nomes precisos. A definição de change lead time do DORA vai do commit no controle de versão ao deploy em produção. Início da tarefa até produção não é essa métrica. É outro intervalo, útil para esta investigação, que inclui trabalho anterior ao commit; chamá-lo de DORA impediria uma comparação honesta.
A pergunta que justifica cada sinal ajuda a evitar um painel cheio e uma decisão vazia:
| Sinal | Decisão que pode informar | Limite da leitura |
|---|---|---|
| Tokens, linhas, sugestões aceitas e PRs | Entender como a ferramenta está sendo usada | Atividade não demonstra valor entregue |
| Tempo ativo relatado pelo autor | Investigar onde a preparação ficou mais fácil | Não inclui o custo para outras pessoas e depende do relato |
| Tempo decorrido na cadeia e em suas etapas | Localizar onde o fluxo mudou | Mistura trabalho, espera e interrupções; não identifica a causa |
| Defeitos que chegaram a produção e retrabalho | Verificar se a qualidade permite manter o workflow | Não atribui automaticamente o problema à IA |
| Relato de autores e revisores | Explicar atritos, correções e contexto | Não substitui os registros de tempo |
Nenhuma linha resolve a avaliação sozinha. Um aumento de PRs pode refletir mudanças menores, mais fragmentação ou mais demanda. Por isso, use sinais que se complementam, não um número para ranquear pessoas.
O ganho local que vira fila
A redução do tempo de preparação só encurta o caminho completo se não criar uma compensação adiante. Gerar mais código pode aumentar o material que alguém precisa entender; produzir uma solução plausível sem compreender suas premissas pode levar a mais rodadas de revisão. São mecanismos possíveis, não um diagnóstico automático de qualquer PR com IA.
A distinção aparece quando você exige que o code review com IA tenha explicação, não confiança. Se o revisor precisa descobrir sozinho o contrato preservado, o caso de falha e a razão do teste, essa descoberta tem custo. Parte dele pode aparecer como correção no PR; outra parte pode virar uma conversa que nenhum status captura.
Só que revisão demorada não prova revisão difícil. Entre ficar pronto para revisão e receber merge, o PR pode ter esperado alguém voltar de férias, passado por alterações de escopo ou recebido correções em paralelo com outra tarefa. O timestamp aponta o trecho a investigar; autor e revisor ajudam a separar as causas.
Há outra armadilha na escolha das tarefas. Quem usa IA pode escolhê-la para trabalho repetitivo e deixá-la de lado em mudanças arriscadas. Comparar esses grupos como se a ferramenta fosse a única diferença confunde seleção de tarefas com efeito da ferramenta. Um antes e depois também mistura o uso de IA com qualquer mudança de equipe, calendário ou processo que tenha ocorrido no intervalo.
Para reduzir essa confusão, mantenha o recorte na mesma classe de tarefa e aplicação. Registre repositório, risco, política de revisão, cadência de release e diferenças no tamanho dos lotes. Uma correção pequena e uma alteração que atravessa serviços não viram equivalentes porque ambas receberam o rótulo de desenvolvimento.
O custo dessa disciplina é trabalho de coleta e uma leitura menos conclusiva. O ganho é não transformar um padrão observado em causa comprovada, nem usar um resultado local para impor adoção ou proibição a todo o time. Quando faltam comparáveis, a incerteza deve aparecer na decisão.
A trilha de eventos da mudança
Comece com marcos recuperáveis, não com um novo dashboard. Para cada mudança do recorte, registre início, momento em que ficou pronta para revisão, merge e deploy, sempre com offset de fuso horário. Vincule os registros à mesma tarefa para não comparar o início de uma demanda com a publicação de outra.
Este helper em Python calcula os intervalos adjacentes a partir desses eventos. Ele foi testado com dados sintéticos para conferir deltas corretos e falhas com campo ausente, ordem inválida e horário sem fuso. Esses testes validam o cálculo ilustrativo, não medem produtividade de um time.
from datetime import datetime


def elapsed_stages(events):
    names = ("started", "review_ready", "merged", "deployed")
    times = [datetime.fromisoformat(events[name]) for name in names]
    if any(t.tzinfo is None for t in times):
        raise ValueError("Timezone required")
    if any(right < left for left, right in zip(times, times[1:])):
        raise ValueError("Events out of order")
    return {
        f"{left}_to_{right}": (end - start).total_seconds()
        for left, right, start, end in zip(names, names[1:], times, times[1:])
    }
O chamador fornece started, review_ready, merged e deployed como strings de data e hora com fuso. A função devolve segundos decorridos em started_to_review_ready, review_ready_to_merged e merged_to_deployed. Ela não calcula horas de trabalho, não identifica participação de IA e não estabelece causalidade.
Um campo ausente gera erro; a função não elimina a tarefa em silêncio. Seu coletor deve registrar dados incompletos, tarefas abertas e abandonos separadamente, sem atribuir duração zero a nenhum deles. Caso contrário, o relatório pode melhorar simplesmente porque deixou de enxergar o trabalho que não chegou ao fim.
O resumo também não basta para uma tarefa reaberta. Defina que review_ready representa a primeira entrada em revisão e preserve o histórico de retornos, em vez de sobrescrever esse evento a cada nova rodada. O intervalo até o merge continuará incluindo esperas e correções, mas será possível investigar o que aconteceu dentro dele.
Ao registrar correções do revisor, separe a evidência de esforço da linha do tempo. Não some horas de pessoas aos intervalos decorridos: além de serem grandezas diferentes, duas pessoas podem trabalhar ao mesmo tempo. Comentários e intervenções ajudam a explicar o intervalo, não entram como parcelas adicionais dele.
O diagnóstico do workflow com IA
Um teste útil precisa de responsável, limite e data de revisão. Antes de começar, combine qual workflow será avaliado, em qual classe de tarefa, o que significa concluído e qual evidência de qualidade impede uma expansão. Decida também quais resultados permitem continuar, restringir o uso ou interromper o teste.
O rótulo de assistência pode ser simples e aplicado no nível da mudança, como preparação com IA, revisão com IA ou uso não informado. Não é preciso arquivar prompts nem rastrear cada tecla. A coleta deve ajudar o time a decidir sobre o trabalho, não criar vigilância individual disfarçada de medição.
Busque uma referência anterior verificável em tarefas comparáveis, com os mesmos marcos e critérios. Se esse histórico não existe, comece a registrar daqui para a frente; não reconstrua uma precisão que os artefatos não permitem. Liste mudanças de equipe, ferramenta e processo junto dos registros, para que elas não sumam quando alguém apresentar o resultado.
Na revisão do teste, olhe o caminho completo e então abra o trecho que mudou. Se a preparação encurtou, mas a etapa de revisão cresceu, investigue disponibilidade e correções antes de escolher uma explicação. Se o tempo até produção caiu e o retrabalho aumentou, o critério de qualidade continua valendo; a leitura não termina no primeiro número favorável.
Esse recorte permite escolher quais workflows de IA vale adotar de forma deliberada, sem exigir uma resposta única para toda atividade de engenharia. E dá um objetivo concreto ao treinamento de IA para o time: corrigir um ponto observado do trabalho e verificar o efeito, em vez de medir familiaridade com uma ferramenta pelo volume de uso.
Reserve tempo de autor e revisor para conferir a medição. Instrumentação também custa; se a coleta exige mais esforço do que a decisão justifica, reduza o recorte antes de comprar mais infraestrutura. Você precisa conseguir explicar uma mudança observada e suas lacunas, não montar um sistema que prometa atribuição automática.
Perguntas frequentes
Nosso time tem poucas tarefas comparáveis. Ainda vale medir?
Vale como investigação do fluxo, sem apresentar poucos casos como prova de ganho geral. Examine os percursos individualmente e preserve diferenças de contexto; se a decisão ainda não tem apoio, mantenha o teste limitado em vez de produzir uma porcentagem conclusiva.
Não temos o horário do deploy. Podemos usar o merge?
Você pode avaliar o caminho até o merge, desde que dê esse nome ao recorte e declare que a entrega em produção permanece desconhecida. Para fechar a lacuna, passe a vincular mudanças ao registro de publicação; o merge não vira deploy por falta de outro evento.
Como medir sem expor prompts e código sensível?
Guarde metadados mínimos, como marcos, classe da tarefa e tipo de assistência, com acesso e retenção definidos. Evite copiar conteúdo para o sistema de medição; quando um caso exigir investigação, examine o artefato nos controles de acesso que ele já tem.
Trocamos de modelo ou de processo no meio do teste. E agora?
Marque a alteração e trate os períodos como contextos diferentes, sem juntá-los numa suposta comparação limpa. Se a troca afetou o mecanismo que você queria avaliar, reformule o teste e a referência antes de ampliar a adoção.
Escolha uma mudança de escopo limitado, trace seu caminho do início ao deploy e confira os marcos com autor e revisor. Registre o que ainda falta saber antes de dizer que a IA acelerou a entrega.