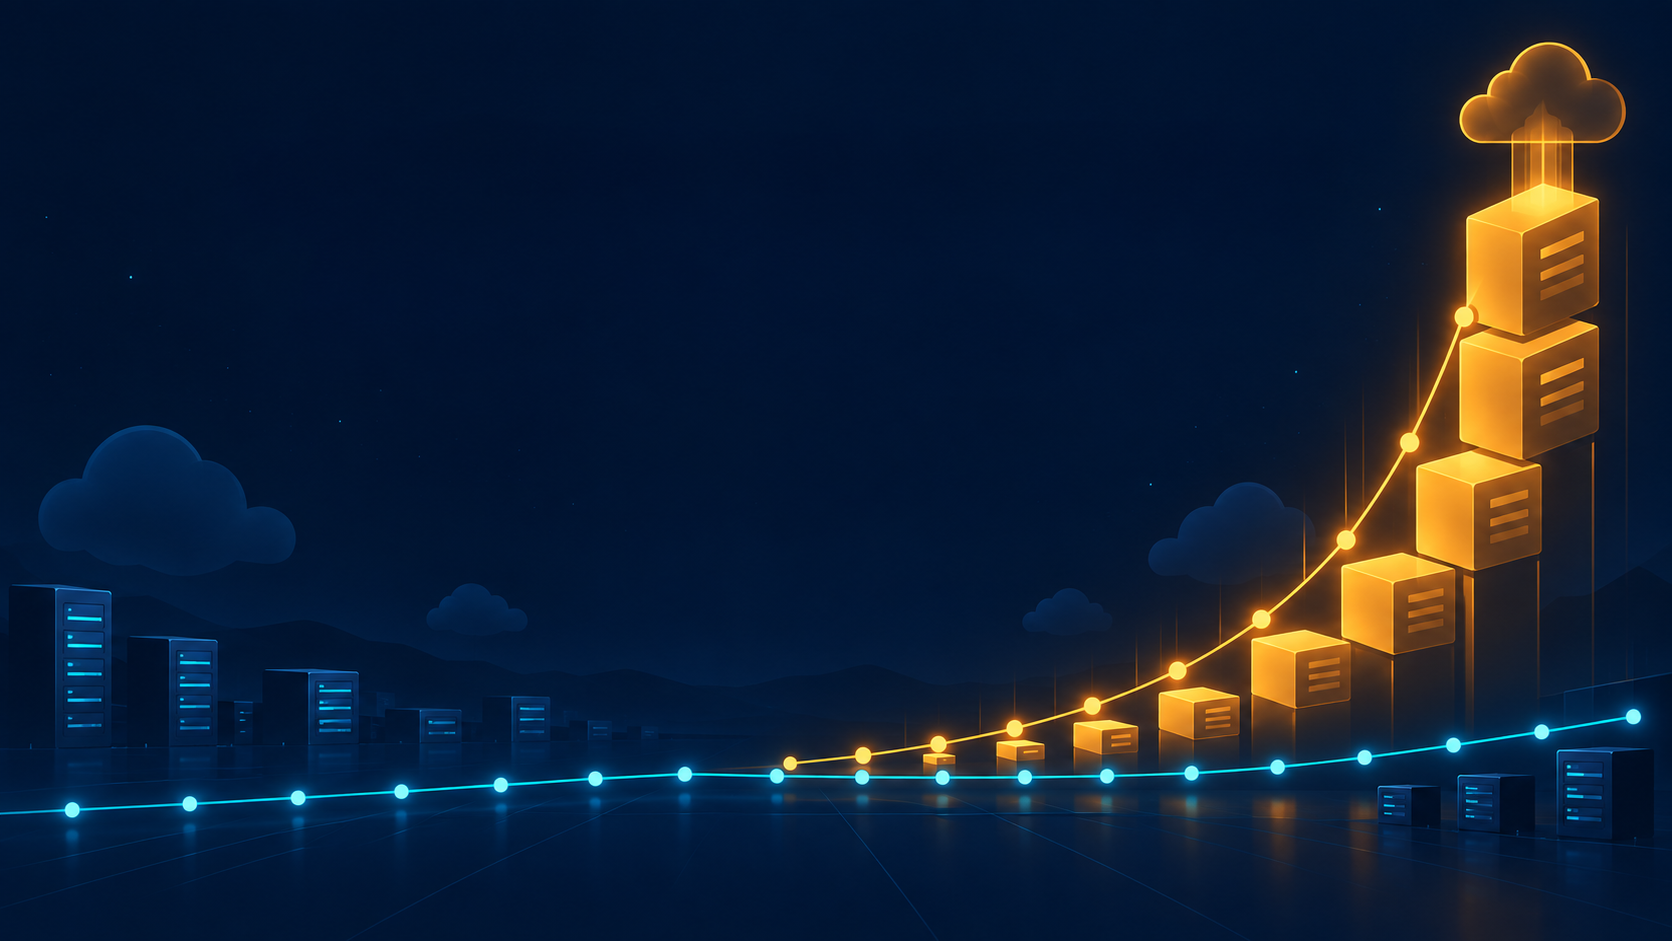
Uma curva de custo pode expor retries, fan-out e capacidade mal medida antes de apontar para uma negociação ruim.
A curva de custo por trás do alerta
O pager toca, a carga parece normal e a próxima projeção de custo já virou assunto de reunião. Quando o gasto acelera sem a mesma alta de trabalho útil, o problema pode estar no desenho do sistema — não na tabela de preços. A consequência chega primeiro: margem pressionada, orçamento interrompendo decisões técnicas e um time buscando desconto antes de saber o que está comprando.
A conta não prova uma causa única. Ela é uma pista para seguir pela requisição, pelo dado e pela capacidade até encontrar onde o sistema está multiplicando trabalho. Em alguns casos, o preço por unidade até cai; só que o número de unidades trabalhadas cresce mais depressa.
O sintoma visto na fatura
Uma curva de gasto que se afasta da curva de carga não diz, por si só, que a nuvem ficou cara. Ela diz que existe uma diferença entre o que entra no sistema e o que ele faz para responder. Mais gasto sem valor proporcional para o usuário costuma aparecer quando cada requisição passa a acionar mais computação, mais transferências ou mais operações de armazenamento do que antes.
Isso muda a conversa entre CTO e Staff engineer. O CTO precisa saber se o custo está comprando capacidade para a próxima demanda ou apenas sustentando desperdício recorrente. A pessoa Staff precisa localizar o mecanismo sem transformar a investigação em uma caça genérica por otimização. A curva é um sintoma operacional, não uma sentença sobre contratos, reservas ou um fornecedor específico.
Também vale desconfiar da palavra “tráfego”. Uma contagem de requisições pode permanecer estável enquanto o trabalho por requisição sobe: um endpoint consulta mais dependências, serializa um payload maior, repete uma escrita ou espera uma fila que cresceu fora de vista. O usuário vê a mesma tela; o sistema faz outra quantidade de trabalho para entregá-la.
O trabalho que a carga multiplica
O caminho mais útil é separar carga de multiplicadores. A carga é o pedido que chega. Os multiplicadores são as decisões e os comportamentos que fazem esse pedido virar várias tentativas, chamadas, leituras, cópias de dados ou minutos de compute sem uso produtivo.
flowchart LR
    C[Carga recebida] --> R[Retries]
    C --> F[Fan-out entre serviços]
    C --> D[Movimentação e serialização de dados]
    C --> O[Capacidade ociosa]
    R --> G[Gasto em nuvem]
    F --> G
    D --> G
    O --> G
    G --> M[Observação: custo, trabalho por requisição e saturação]
    M -. comparar com a carga .-> C
    M -. investigar multiplicadores .-> R
    M -. investigar multiplicadores .-> F
    M -. investigar multiplicadores .-> D
    M -. investigar multiplicadores .-> O
O diagrama não é uma cadeia causal obrigatória. Ele organiza a investigação: a mesma carga pode gerar gastos muito diferentes dependendo de como o sistema reage a ela. Um retry, por exemplo, pode ser a proteção correta contra uma falha transitória. O custo aparece quando a política repete trabalho que não tem chance razoável de terminar, quando a tentativa não é idempotente ou quando o cliente, a fila e o serviço de destino passam a repetir a mesma operação em camadas diferentes.
O fan-out tem um padrão parecido. Uma chamada de entrada que vira várias chamadas internas pode ser aceitável para compor uma resposta. Só que esse desenho muda o custo total e o comportamento em falha: uma dependência lenta transforma uma requisição em várias esperas, e uma pequena degradação se espalha pelo caminho. Fan-out paga em dependências e coordenação, não apenas em CPU.
Leituras e escritas repetidas também merecem ser tratadas como trabalho, não como detalhe de implementação. Buscar o mesmo dado em mais de uma camada, reserializar objetos grandes entre serviços ou mover dados para perto do compute pode aumentar transferências e tempo de execução sem melhorar a resposta entregue. O problema não é que dados se movem; o problema é não saber por que se movem nem quem precisa deles.
Há ainda a capacidade que fica de pé esperando uma demanda irregular. Manter instâncias, workers ou pools dimensionados para um pico raro pode dar previsibilidade de latência, mas deixa compute ocioso entre os picos. Isso não é automaticamente desperdício. Capacidade ociosa pode ser um custo deliberado de disponibilidade, desde que o time consiga apontar qual risco ela compra.
Pontos de quebra na escala
Os multiplicadores costumam se combinar. Uma fila cresce, o timeout dispara, o cliente tenta de novo e o serviço já ocupado leva ainda mais tempo para responder. A conta sobe não porque o sistema recebeu mais valor para processar, mas porque passou a trabalhar mais para falhar ou esperar. O ciclo é especialmente difícil de ver quando cada componente mostra apenas sua própria métrica.
Abaixo está um exemplo de instrumentação que ajuda a preservar a relação entre uma requisição e o trabalho que ela provoca. Não é evidência de um runtime específico; é um formato de pergunta que o time pode adaptar ao seu ambiente.
observabilidade:
  por_rota:
    - requisicoes
    - tentativas_por_requisicao
    - chamadas_dependentes_por_requisicao
    - bytes_transferidos_por_requisicao
    - tempo_ocioso_de_capacidade
  correlacao:
    chave: id_da_requisicao
  alerta:
    condicao: trabalho_por_requisicao_sobe_sem_carga_equivalente
Autoscaling também pode ampliar a diferença quando reage ao sinal errado. Escalar por utilização de CPU pode ser razoável em um serviço limitado por CPU; pode ser enganoso quando a espera está em I/O, em lock, em uma dependência externa ou em uma fila cujo atraso ainda não virou consumo local. Escalar o sintoma errado adiciona capacidade sem remover o gargalo e pode aumentar a superfície que precisa ser coordenada.
Reservas, compromissos de uso e descontos entram depois dessa separação. Eles podem reduzir o preço pago por uma unidade de trabalho, o que pode ser uma decisão financeira correta. Só não reduzem o número de chamadas, bytes, retries ou minutos de compute. Tratar preço e trabalho como se fossem a mesma alavanca permite que uma economia unitária esconda uma expansão do volume total.
Diagnóstico por trabalho útil
O diagnóstico começa escolhendo um fluxo que tenha valor claro para o usuário ou para o negócio e acompanhando-o de ponta a ponta. Não comece pelo maior item da fatura nem pelo serviço que parece mais caro. Comece por uma unidade de trabalho reconhecível: uma operação concluída, um documento processado, uma atualização persistida, uma resposta realmente entregue.
Para esse fluxo, registre a carga de entrada e compare-a com o trabalho criado ao longo do caminho. Quantas tentativas são feitas? Quantas dependências são chamadas? Quanto dado atravessa fronteiras? Quanto tempo de capacidade fica reservado enquanto a demanda está baixa? O denominador importa: custo absoluto sem uma unidade de trabalho pode indicar volume, ineficiência ou os dois ao mesmo tempo.
A investigação precisa manter causas alternativas abertas. Se retries crescem, procure timeout, indisponibilidade, concorrência excessiva e políticas duplicadas antes de declarar que “o retry é o problema”. Se transferência sobe, veja se a mudança veio de payload, de repetição de leitura, de localização do dado ou de uma nova fronteira entre serviços. O objetivo não é encontrar uma métrica culpada; é montar uma explicação que sobreviva à próxima mudança de carga.
Vale cruzar esse diagnóstico com planejamento de capacidade feito no calendário, não no pager. Planejar capacidade é decidir antecipadamente qual pico precisa ser atendido e qual degradação é aceitável. Diagnosticar a curva de custo mostra se a capacidade atual está sendo usada para atender essa decisão ou para compensar um caminho de trabalho mal comportado.
Uma boa leitura termina em uma frase verificável, mesmo sem prometer uma economia: “esta rota cria tentativas repetidas quando a dependência fica lenta”; “este payload é serializado e movido mais de uma vez”; “este pool permanece grande porque o sinal de escala não representa a fila”. Uma explicação específica permite uma mudança reversível; “a nuvem está cara” não permite.
Ações que trocam um custo por outro
Reduzir trabalho quase nunca é só desligar uma despesa. Cache pode eliminar leituras repetidas, mas cobra em freshness e invalidação. Batching pode reduzir overhead de rede e armazenamento, mas pode adicionar espera até formar um lote. Backpressure pode impedir que o sistema amplifique uma falha, mas desloca parte da latência ou da rejeição para quem envia a demanda.
Idempotência é outro exemplo importante. Fazer uma operação suportar repetição evita que retries criem efeitos duplicados, mas exige chaves, estado e regras claras de reconciliação. Quem paga é o time de produto e operação: em troca de menos trabalho inútil e menos efeitos inesperados, precisa decidir o que o usuário vê quando uma operação está pendente, repetida ou rejeitada.
Em alguns fluxos, a restrição correta está no produto. Limitar o tamanho de um payload, reduzir a frequência de atualização, adiar uma operação não crítica ou recusar uma combinação cara de filtros pode cortar trabalho na origem. Isso paga em experiência, liberdade de uso ou latência percebida. Esconder esse custo sob a palavra “otimização” produz decisões ruins, porque alguém vai pagar depois — geralmente suporte, produto ou o usuário final.
A primeira intervenção deve ser pequena o bastante para desfazer. Escolha um fluxo, adicione correlação entre requisição e trabalho gerado, e altere uma única política: por exemplo, um limite de retry, uma chave de idempotência, um batch com janela explícita ou um sinal de autoscaling que represente a fila real. Depois compare o trabalho por unidade útil antes e depois, sem confundir mudança de preço com mudança de comportamento.
Para estruturar essa investigação como parte de uma prática recorrente, veja o trabalho de scaling da Manila Studio: o ponto não é perseguir a menor fatura isoladamente, e sim manter capacidade, falha e custo legíveis à medida que o sistema cresce.
Perguntas frequentes
Descontos e reservas deixam de fazer sentido quando há desperdício?
Não. Eles podem reduzir o preço de uma capacidade que você já decidiu manter. O cuidado é não usar uma redução de preço unitário como evidência de que o sistema está fazendo menos trabalho ou de que a capacidade comprada ainda é a decisão certa.
Cache é sempre a primeira resposta para leituras repetidas?
Não. Cache ajuda quando a repetição é legítima e a política de freshness é aceitável. Se a leitura se repete porque uma fronteira de serviço foi desenhada de forma confusa ou porque o mesmo fluxo faz fan-out desnecessário, o cache pode esconder o mecanismo sem resolvê-lo.
Como tratar retries sem perder resiliência?
Mantenha retries onde uma falha transitória justifica nova tentativa, mas limite tentativas, evite duplicação entre camadas e garanta idempotência quando a operação tiver efeito persistente. O comportamento em exaustão também precisa ser explícito: fila, falha controlada, degradação ou intervenção manual.
Capacidade ociosa é sempre um erro de dimensionamento?
Não. Ela pode comprar latência previsível, recuperação mais rápida ou margem para um pico conhecido. O erro é não conseguir ligar essa capacidade a uma demanda, a um objetivo de serviço ou a um risco que o time escolheu aceitar.
Na próxima ocorrência, escolha uma rota que acordaria alguém no pager e registre, antes de mudar preço ou capacidade, quantas unidades de trabalho ela cria para cada resultado útil.